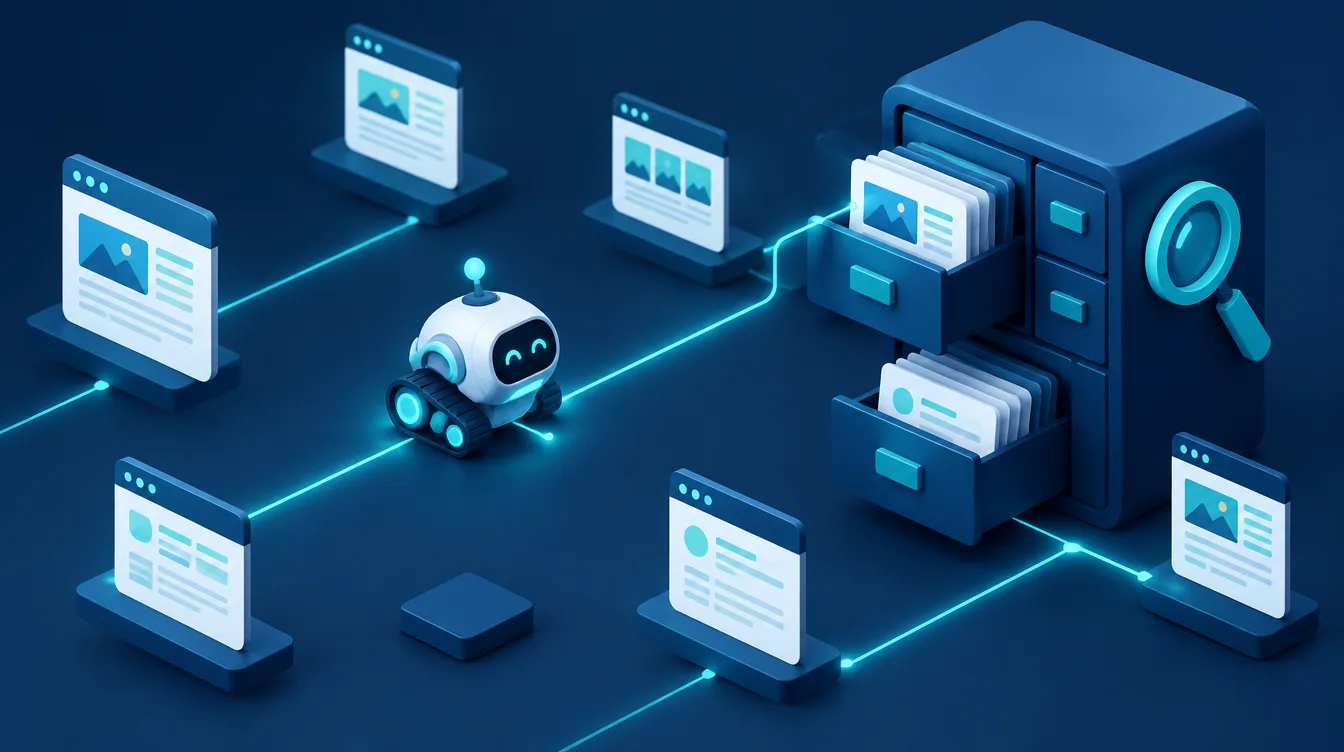
Indexácia webu v Google znamená, že Google stránku prehľadal, vyhodnotil a uložil do svojho indexu, teda do databázy, z ktorej skladá výsledky vyhľadávania. Stránka, ktorá v indexe nie je, sa vo vyhľadávaní nezobrazí na žiadny dopyt, nech je obsah akokoľvek dobrý. Pred indexáciou ju musí nájsť a stiahnuť crawler (pri Google je to Googlebot). V článku vysvetľujeme, ako prehľadávanie a indexácia fungujú, ako zistiť, prečo stránka v indexe chýba, a čo naozaj pomáha.
V skratke:
- Vyhľadávač pracuje v troch krokoch: prehľadávanie (crawler stiahne stránku), indexácia (uloží ju) a zobrazenie vo výsledkoch.
- Google podľa vlastnej dokumentácie nezaručuje, že každú stránku prehľadá a zaindexuje. 100 % indexácia nie je cieľ.
- Najčastejšie príčiny chýbajúcich stránok: zabudnutý noindex, blokovanie v robots.txt, duplicity, slabý obsah a stránky bez interných odkazov.
- Stav konkrétnej stránky zistíte v Google Search Console nástrojom na kontrolu URL (URL Inspection).
- Nová stránka sa do indexu zvyčajne dostane za niekoľko dní, niekedy až za niekoľko týždňov. Opakované žiadosti to neurýchlia.
Crawler, prehľadávanie a indexácia: tri kroky vyhľadávača
Crawler (aj robot, bot alebo spider) je program, ktorý automaticky sťahuje webové stránky a sleduje odkazy na nich. Google používa Googlebota, Microsoft Bingbota a český vyhľadávač Seznam svojho robota SeznamBot. Prehľadávanie (anglicky crawling) je fáza, keď crawler stránku nájde, stiahne a spracuje. Indexácia je následné vyhodnotenie obsahu a uloženie stránky do indexu. Google opisuje celý proces takto:
| Krok | Čo sa deje | Typický problém |
|---|---|---|
| 1. Prehľadávanie | Googlebot nájde URL cez odkazy alebo sitemap, stiahne ju a vykreslí vrátane JavaScriptu | chyby servera, blokovanie v robots.txt, stránka za prihlásením |
| 2. Indexácia | Google analyzuje text, title, alt texty, obrázky, vyberie kanonickú verziu spomedzi podobných stránok a uloží ju | značka noindex, duplicitný alebo málo hodnotný obsah |
| 3. Zobrazenie | pri vyhľadávaní Google vyberie z indexu najrelevantnejšie výsledky | stránka je v indexe, ale pre dopyt nie je dosť relevantná |
Dôležité rozlíšenie: prehľadanie ešte neznamená indexáciu. Google môže stránku prehľadať a rozhodnúť sa ju neuložiť. A naopak, stránka zablokovaná v robots.txt sa môže dostať do indexu bez obsahu, ak na ňu vedú odkazy z iných webov.
Ako crawler web nájde a prehľadáva
Centrálny register všetkých webových stránok neexistuje. Googlebot objavuje nové adresy dvoma hlavnými cestami: cez odkazy z už známych stránok a cez súbory sitemap. Preto sa nová stránka bez jediného interného odkazu a mimo XML sitemap objavuje pomaly alebo vôbec.
Stránky Google vykresľuje v aktuálnej verzii prehliadača Chrome a spúšťa JavaScript. Ak sa hlavný text alebo odkazy načítajú až po kliknutí či inej interakcii používateľa, crawler ich nemusí vidieť.
Rýchlosť prehľadávania závisí od toho, ako rýchlo a spoľahlivo odpovedá server. Podľa dokumentácie Google začína každý web s rovnakým, konzervatívnym limitom, ktorý Google zvyšuje, ak je o obsah záujem a server ostáva zdravý. Pomalé odpovede a chyby 5xx alebo 429 prehľadávanie spomaľujú. Rýchly a spoľahlivý hosting tak ovplyvňuje aj indexáciu, nielen rýchlosť webu pre návštevníkov.
Pojem crawl budget (rozpočet prehľadávania) rieši podľa Google hlavne veľké weby: približne od 1 milióna unikátnych stránok, ktoré sa menia zhruba týždenne, alebo od 10 000 stránok, ktoré sa menia denne. Bežnému firemnému webu alebo menšiemu e-shopu stačí aktuálna sitemap a pravidelná kontrola prehľadu indexovania stránok.
Ako zistiť, či je stránka zaindexovaná
- 1Operátor site: – do Google zadajte `site:vasadomena.sk` pre celý web alebo `site:` s celou adresou stránky. Je to rýchly orientačný test, počet výsledkov však nie je presný.
- 2Kontrola URL v Google Search Console – vložte adresu do vyhľadávacieho poľa navrchu. Nástroj ukáže, či je stránka v indexe, kedy ju Googlebot naposledy prehľadal, akú kanonickú URL Google zvolil a prečo prípadne indexovaná nie je. Test živej verzie (Test live URL) overí aktuálny stav stránky.
- 3Prehľad indexovania stránok (Page indexing) – súhrn za celý web: koľko stránok je v indexe a z akých dôvodov ostatné nie sú. Ako Search Console nastaviť a čítať ďalšie prehľady, opisujeme v návode Google Search Console pre SEO.
Prečo stránky nie sú v indexe: najčastejšie dôvody
Prehľad indexovania stránok uvádza pri neindexovaných URL konkrétny dôvod. Názvy nižšie sú v anglickej podobe, ako ich Search Console zobrazuje v angličtine, s vysvetlením:
| Dôvod v Search Console | Čo znamená | Čo urobiť |
|---|---|---|
| Excluded by 'noindex' tag | stránka obsahuje príkaz „neindexovať“ | ak má byť vo vyhľadávaní, noindex odstráňte (častý pozostatok testovacej verzie) |
| Blocked by robots.txt | crawler nesmie stránku stiahnuť | upravte pravidlo v robots.txt, ak stránku chcete v indexe |
| Crawled – currently not indexed | Google stránku stiahol, ale zatiaľ ju neuložil | zlepšite obsah a interné odkazy; opakované odoslanie podľa Google nie je potrebné |
| Discovered – currently not indexed | Google o URL vie, ale zatiaľ ju neprehľadal | pridajte interné odkazy, skontrolujte rýchlosť servera a sitemap |
| Duplicate / Alternate page with proper canonical tag | Google zvolil ako hlavnú inú URL | pri zámerných duplicitách nič; inak zjednoťte obsah a kanonické URL |
| Not found (404) a Soft 404 | stránka neexistuje alebo tak len vyzerá | pri presunutom obsahu nastavte presmerovanie 301 |
| Server error (5xx) a Redirect error | server neodpovedal alebo reťazec presmerovaní je chybný | riešte s vývojárom alebo hostingom |
Dve veci, ktoré sa často pletú. Po prvé: robots.txt blokuje prehľadávanie, nie indexáciu. Ak chcete stránku z vyhľadávania skryť, použite noindex a stránku v robots.txt neblokujte, inak Google príkaz noindex vôbec neprečíta. Po druhé: stav „Crawled – currently not indexed“ zvyčajne nie je technická chyba, ale signál, že Google obsah nepovažuje za dosť užitočný alebo odlišný od iných stránok. Pomôže lepší text podľa zásad SEO copywritingu, zlúčenie podobných stránok a viac interných odkazov.
Zaindexovanie stránky v Google krok za krokom
Postup pre novú alebo upravenú stránku, ktorá má byť vo vyhľadávaní:
- 1Skontrolujte, že stránka nemá noindex a že ju neblokuje robots.txt ani prihlásenie.
- 2Overte stavový kód 200 a nastavte správnu kanonickú URL (pri webe na HTTPS len jednu verziu adresy).
- 3Pridajte stránku do XML sitemap a sitemap odošlite v Search Console. Pri upravených stránkach pomáha aktuálny údaj lastmod.
- 4Odkážte na stránku z iných stránok webu, ideálne z menu, kategórie alebo tematicky blízkeho článku.
- 5V nástroji na kontrolu URL požiadajte o indexovanie (Request indexing). Počet žiadostí za deň je obmedzený a žiadosť zaradenie do indexu nezaručuje.
- 6Počkajte a sledujte stav. Riešiť problém má podľa Google zmysel až zhruba týždeň po odoslaní sitemap alebo žiadosti o indexovanie.
Ako dlho indexácia trvá
Pri novo publikovaných stránkach trvá indexácia podľa pomocníka Google od jedného až dvoch dní do niekoľkých týždňov. Opravu chýb v prehľade indexovania si môžete nechať overiť tlačidlom na overenie opravy (Validate fix); validácia podľa Google zvyčajne trvá do približne dvoch týždňov.
Prečo to trvá rôzne dlho: rozhoduje, ako často Googlebot web navštevuje, koľko na stránku vedie interných a spätných odkazov a ako rýchlo server odpovedá. Nový web bez odkazov z iných webov má zvyčajne dlhší štart ako zavedený web, ktorý Googlebot navštevuje denne.
Čo indexáciu neurýchli
- Opakované žiadosti o indexovanie tej istej URL. Limit je denný a ďalšia žiadosť proces neurýchli.
- Indexing API od Google pre bežné stránky. Podľa dokumentácie sa dá použiť len pre stránky s pracovnými ponukami (JobPosting) a živým videom (BroadcastEvent).
- Platené „služby rýchlej indexácie“ a hromadné odkazy z bezcenných webov. Dlhodobo pomáhajú kvalitné spätné odkazy, o ktorých píšeme v článku o linkbuildingu.
- Generovanie stoviek podobných stránok (napríklad kombinácie miest a služieb s takmer rovnakým textom). Takéto stránky zvyčajne skončia ako duplicitné alebo neindexované.
Modelový príklad: nový web, ktorý Google nevidí
Nasledujúci príklad je fiktívny, ale zodpovedá situáciám z praxe. Firma spustí nový web, no ani po troch týždňoch ju Google nenájde ani na vlastný názov. Kontrola URL ukáže stav „Excluded by 'noindex' tag“: vývojár na testovacej verzii zapol v CMS voľbu „neindexovať web“ a po spustení ju zabudol vypnúť. Po odstránení noindexu, odoslaní sitemap a žiadosti o indexovanie sa úvodná stránka a hlavné služby objavia v indexe v priebehu niekoľkých dní, zvyšok webu postupne podľa toho, ako Googlebot prechádza odkazy. Podobné chyby odhalí SEO audit webu a mala by ich obsahovať kontrola pred každým spustením webu.
Kedy zveriť indexáciu odborníkovi
Jednu chýbajúcu stránku zvyčajne vyriešite sami podľa postupu vyššie. Odborníka sa oplatí prizvať, keď v prehľade indexovania pribúdajú stovky neindexovaných URL, po redizajne alebo presune domény klesla návštevnosť, e-shop generuje duplicity cez filtre a parametre, alebo web stojí na JavaScripte a Google nevidí obsah. V rámci SEO služieb robíme technické audity, opravy indexácie a nastavenie Search Console; o technickú prevádzku webu sa postaráme aj v rámci správy webu. Ak riešite konkrétny problém, napíšte nám. Ďalšie články o optimalizácii nájdete v kategórii SEO.
Časté otázky
Čo je crawler?
Aký je rozdiel medzi prehľadávaním a indexáciou?
Ako dlho trvá zaindexovanie stránky v Google?
Ako zistím, či je moja stránka v indexe Google?
Prečo Google stránku prehľadal, ale nezaindexoval?
Zdroje
Autor
Peter GáboríkProjektový manažér – AI, automatizácia a SEO
Projektový manažér a zakladateľ Weboptimu. Vymýšľa stratégie pre rast firiem cez SEO, automatizáciu a AI, s online marketingom pracuje od roku 2017.
Súvisiaca služba
Tipy, ktoré ušetria čas – raz mesačne
Jeden e-mail mesačne: nový návod, automatizácia mesiaca a jedno číslo z praxe. Žiadny spam.